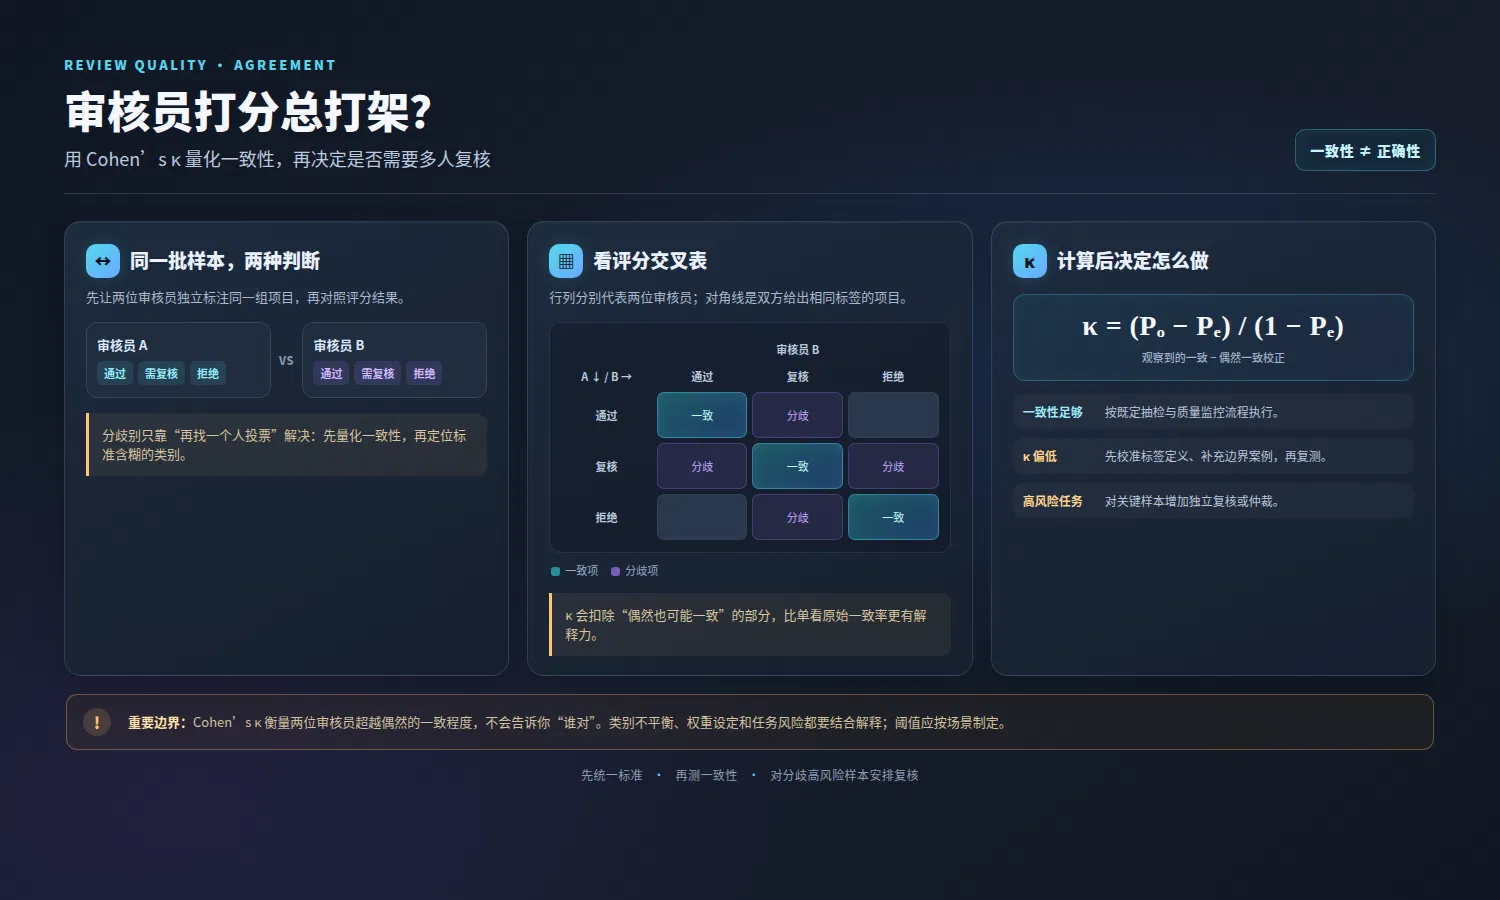
当审核员对内容质量评分不一致时,应通过统计方法量化分歧程度,并依据风险等级制定单人复核或多人确认的标准化策略。
⚖️ 解决审核分歧的核心策略:分级处理与量化一致性
审核差异源于“客观规则”与“主观评估”的边界冲突。高效团队通过以下双轨策略解决分歧:
策略一:区分风险等级
常规项 (低风险): 格式、链接等硬指标,单人复核或自动化拦截,无需纠结。
关键项 (高风险): 逻辑、合规、AI生成等主观判断项,必须引入多人复核。
策略二:量化一致性数据
引入 **Cohen’s kappa** 等统计工具衡量评分者间信度。
将模糊的主观分歧转化为可量化的可靠性指标,而非依赖个人权威争论。
为什么审核员意见不一致:从规则判断到主观评估的边界
审核差异源于客观规则与主观评估的边界冲突,需先区分无需纠结的常规项与必须深究的高风险项以明确处理优先级。
多人参与质量审核时,评分出现差异是必然现象。这并非有人偷懒或失职,而是“客观规则”与“主观判断”在碰撞。你只需先分清哪些项不用纠结,哪些必须深究。
哪些检查不用纠结
标题是否为空、链接是否断裂、文章是否重复,这些属于硬指标[1]。它们像开关一样非黑即白,适合用规则引擎自动拦截,或由资深编辑单人快速复核。遇到这类问题,不需要拉通多人讨论,更无需计算复杂的统计值。
哪些情况必须深入分析
当内容涉及步骤是否可执行、政策表达是否过度承诺、限制条件是否充分,或是故障排除路径能否覆盖主要情境时,标准就模糊了[1][2][3]。这类依赖经验与语境的项目,不同审核者极易产生分歧。若仅靠个人直觉,小团队也会陷入无休止的争论。此时,必须引入统一的标准框架,甚至动用一致性统计工具来校准尺度。
实战避坑指南:很多新手团队在制定评分细则时,最容易犯的错误是将“逻辑通顺”这种抽象概念直接作为扣分项,却未定义何为“不通顺”。例如,A 审核员认为“缺少具体报错代码截图”导致逻辑缺失,B 审核员则认为“文字描述已足够清晰”。这种分歧往往源于对“证据颗粒度”缺乏量化标准。建议在细则中强制规定:对于技术类故障排除,必须包含“复现环境 错误代码 解决步骤”三要素,缺一不可。将模糊的定性描述转化为具体的清单(Checklist),能直接从源头减少 80% 因理解偏差导致的无效争论。
解决审核员意见不一致:引入 Cohen’s kappa 衡量一致性
Cohen’s kappa 是衡量两名审核员评分一致性的核心统计工具,能将模糊的主观分歧转化为可量化的可靠性数据而非依赖个人权威。
当两个审核员对同一篇文章给出不同分数时,别急着争论谁更“专业”。在质量控制领域,可靠性不是看谁眼光毒辣,而是看测量结果是否稳定一致[2]。解决这个问题的核心工具是 Cohen’s kappa,它能帮你把模糊的主观分歧变成可量化的数据。
Cohen’s kappa 如何帮助判断谁对谁错
这个指标并不直接判定谁对谁错,它只负责量化分歧的程度。如果计算出的 Kappa 值很高,说明大家用的尺子是一样的,标准已经统一;如果数值很低,那问题不在人,而在规则本身——你需要重新培训团队或修订评分细则[3]。
想象一下,你让两个人分别给文章打分。如果两人完全随机打分,Kappa 会是负数;如果两人看法完全一致,Kappa 就是 1.0。这个指标专门处理名义或离散编码数据,比如“通过/不通过”、“高风险/低风险”这种非此即彼的判断[3]。它让你看清:所谓的“意见不一致”,究竟是偶然的误差,还是标准本身的混乱。
从研究工具到治理工具:何时开始计算一致性
很多小团队觉得统计太复杂,其实只有特定场景才需要启动这套流程。当审核结果直接影响 AI 自动回答、涉及合规风险、跨团队协作或外包审核时,一致性统计的边际价值才会飙升[4][2]。
在此之前,像标题是否为空、链接是否断裂这类硬指标,用规则或单人检查就能搞定,没必要搞大动干戈[1]。但一旦涉及步骤是否可执行、政策承诺是否过度、故障路径是否覆盖这些依赖主观判断的环节,就必须引入统计手段了[1][2]。此时,CAQDAS 等软件能帮你增强可追溯性,留下清晰的审计轨迹,证明你的审核过程是可复现、可训练的[3]。
案例多元化补充:在之前的案例中我们常提到通用知识库的审核,但在金融合规领域,某大型支付平台曾面临类似困境。他们的审核员对“风险提示语”的强弱判断不一,导致部分用户投诉未被及时拦截。该团队没有单纯依赖资深编辑的经验,而是引入了 Cohen’s kappa 进行抽样测试,发现两名审核员在“是否需要加粗警示语”这一项上 Kappa 值仅为 0.2。进一步分析发现,是因为旧版 Rubric 中对“高风险”的定义包含了“金额大小”和“操作类型”两个维度,而新入职员工只关注了金额。通过修正评分表,明确“只要涉及资金转出,无论金额大小均需加粗”,Kappa 值迅速回升至 0.85。这个案例表明,低 Kappa 值往往是规则定义维度的错位,而非人员能力问题。
本节行动清单:
[ ] 确认争议内容是否属于高风险或影响自动化决策
[ ] 收集至少 20 条双人复核样本数据
[ ] 使用工具计算 Cohen’s kappa 值
[ ] 若 Kappa < 0.4,立即暂停发布并修订评分标准
[ ] 将计算过程和原始记录归档为审计轨迹
小团队也能做好审核:无需统计时的替代复核策略
小团队在低风险或高度标准化场景下,可由资深编辑集中决策替代复杂统计流程,从而在不计算信度系数时依然高效保障质量。
没有 inter-rater reliability(评分者间信度)统计,并不意味着小团队审核必然失败[1]。很多小团队陷入焦虑,以为必须算出 Cohen’s kappa 才能证明质量达标。其实对于低风险、低访问、模板高度标准化的内容,资深编辑集中审核往往比复杂的统计流程更高效[2]。你不需要把每个操作都变成数学题,只要把判断权交给经验最丰富的人,就能在特定场景下快速解决问题。
如何建立简单的审计轨迹而不依赖复杂统计
既然放弃了繁琐的统计指标,你该如何证明审核过程是可信的?答案在于建立“简单的审计轨迹”。不要试图记录每一个微小的打分细节,而是聚焦于关键决策点和争议原因。当资深编辑对某篇文章做出修改或驳回决定时,只需在后台备注栏写下核心依据。例如:“标题缺失导致用户无法检索”或“故障步骤未覆盖主流浏览器环境”[3]。这种记录方式不追求数字上的完美一致性,但能清晰还原当时的判断逻辑。
组织在需要证明过程可追溯时,基础记录同样具有治理价值[1]。你不需要用软件去追踪编码数据,只需要确保每条修改意见都能对应到具体的规则条款或业务场景。如果未来有人质疑某次处理结果,这些简明的备注就是最有力的证据。这种方法特别适合那些不需要证明过程可复现、可训练的日常运营场景[1]。当审核结果不涉及 AI 自动回答、合规风险或跨团队协作时,这种轻量级的管理方式足以维持高质量输出[4]。
本章执行检查清单
[ ] 确认内容属于低风险、低访问或模板标准化类别
[ ] 指派资深编辑进行集中审核,而非分散多人打分
[ ] 在备注中记录关键决策点及具体原因(非单纯打分)
[ ] 仅在涉及高风险或需对外证明时可启动复杂统计
构建可信赖的审核体系:何时必须启动多人复核机制
涉及 AI 生成、合规红线或跨团队协作等高风险场景时,必须启动多人复核机制以证明审核过程的可追溯性与结果的可复现性。
当你的审核结果直接决定 AI 的回答、触碰合规红线或涉及跨团队协作时,单人判断的边际价值正在下降 [4]。此时,你需要从“谁说得对”转向“如何证明过程可靠”。组织必须证明审核过程可追溯、可复现且具备训练潜力,Cohen’s kappa 等统计方法才真正从研究工具转化为治理工具 [3]。
决策的核心逻辑很明确:依据内容风险等级分配人力。低风险项如标题缺失、链接断裂或重复文章,规则清晰,单人检查即可 [1]。但一旦涉及步骤的可执行性、政策承诺是否过度或故障路径覆盖度,这些依赖主观判断的环节就必须引入多人复核 [2]。
以下清单列出了必须启动多人复核的高风险场景,请严格执行:
涉及合规风险:内容可能引发法律纠纷或监管处罚,需双人以上确认措辞边界。
AI 生成内容:模型生成的回答直接影响用户决策,必须通过多重校验防止幻觉。
外包协作场景:外部团队参与审核时,需建立统一标准以消除认知偏差。
跨团队协作:不同部门对同一内容的理解存在分歧,需仲裁机制定调。
高访问模板内容:流量巨大的核心页面,错误成本极高,需资深编辑集中复核。
| 场景类型 | 单人复核可行性 | 推荐策略 | 关键依据 |
|---|---|---|---|
| 格式与基础检查 | 高 | 单人 自动化 | 规则明确,无歧义 [1] |
| 政策与逻辑判断 | 低 | 多人复核 统计 | 依赖主观标准,易有偏差 [2][3] |
| 合规与法律风险 | 极低 | 强制多人确认 | 容错率几乎为零 [4] |
| AI 生成内容审核 | 低 | 多人交叉验证 | 需防止模型幻觉扩散 [4] |
| 外包团队作业 | 中 | 抽检 一致性校准 | 需拉齐外部标准 [3] |
最终目标不是追求完美的统计数据,而是确保评估体系的稳定性。没有统计指标不代表小团队无法工作,但在高风险领域,缺乏审计轨迹和一致性记录会让质量失控 [1]。只有当组织需要对外证明审核的严谨性时,这套多人复核机制才是必要的防线。
本章执行检查清单
[ ] 识别当前任务是否涉及合规、AI 生成或外包协作
[ ] 若是,立即启动双人或多人复核流程
[ ] 保留完整的复核记录与修改痕迹作为审计轨迹
[ ] 对高风险项应用离散编码,确保判断标准一致
[ ] 定期计算一致性指标(如 Cohen’s kappa)监控质量波动
FAQ: 关于审核一致性的常见疑问
Q: 如果团队很小,真的有必要算 Cohen’s kappa 吗?A: 不一定。如果内容风险低、流程标准化程度高,或者只是内部参考,资深编辑的集中审核往往效率更高。统计工具更适合高风险、跨团队协作或需要对外证明质量的场景。
Q: Kappa 值低一定是审核员的问题吗?A: 恰恰相反。Kappa 值低通常意味着评分标准(Rubric)定义不清,或者审核员对标准的理解存在巨大差异。这时候应该先优化规则,而不是责怪人。
Q: 除了 Cohen’s kappa,还有其他衡量一致性的方法吗?A: 是的,根据数据类型不同,还有 Fleiss’ kappa(用于多人)、Intraclass Correlation Coefficient (ICC)(用于连续分数)等。但对于“通过/不通过”这种二元判断,Cohen’s kappa 依然是行业金标准。
参考来源
Article Quality Index (AQI) - NiCE Knowledge Success Center · https://expert-help.nice.com/Success/Self-Service_Strategy/KCS_Methodology/AQI(A级)
Reliability and Validity · https://chfasoa.uni.edu/reliabilityandvalidity.htm(C级)
Inter-Rater Reliability Methods in Qualitative Case Study Research - Rosanna Cole, 2024 · https://journals.sagepub.com/doi/10.1177⁄00491241231156971?icid=int.sj-abstract.citing-articles.36(S级)
Mastering knowledge management for great AI support | Intercom Help · https://www.intercom.com/help/en/articles/11782981-mastering-knowledge-management-for-great-ai-support(A级)